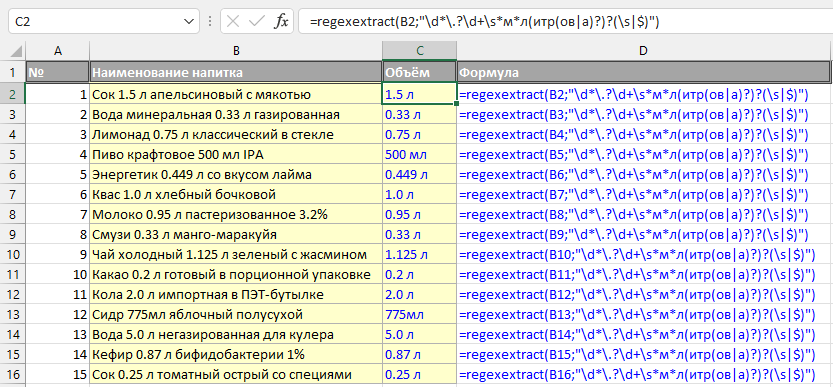
Регулярные выражения в Excel работают через функции: =REGEXMATCH(A2;"\d{5}") проверяет, есть ли в тексте пять цифр подряд, =REGEXEXTRACT(A2;"\d{5}") извлекает их, а =REGEXREPLACE(A2;"\d";"") удаляет все цифры. В Excel 365 есть встроенные аналоги — РЕГТЕСТ, РЕГИЗВЛЕЧЬ и РЕГЗАМЕНИТЬ, а в Excel 2010–2021 те же функции добавляет бесплатная версия надстройки !SEMTools. Ниже — синтаксис, шпаргалка по шаблонам и десятки готовых примеров.
Многие слышали, что такое регулярные выражения, но не всем известно, что они поддерживаются "под капотом" Microsoft Excel. Регулярные выражения дают возможность многократно ускорить работу с текстом, находить в нем самые замысловатые паттерны и решать самые сложные исследовательские задачи.
Регулярное выражение (в простонародье — регулярка, англ. regular expression, RegEx) — это шаблон, который описывает, как выглядит искомый текст: «четыре цифры подряд», «слово с заглавной буквы», «всё, что стоит после последней запятой». Excel проверяет каждую ячейку на соответствие шаблону и находит, извлекает или заменяет подходящие фрагменты.
Встроенные функции регулярных выражений есть только в Excel 365. В Excel 2010–2021 их нет, и до недавнего времени единственным способом использовать регулярки в этих версиях было писать собственные функции на VBA.
Но с надстройкой !SEMTools это не нужно! Функции регулярных выражений работают в любой версии Excel, начиная с 2010, и доступны даже в бесплатной версии надстройки бессрочно.
А минимальное понимание синтаксиса регулярок позволит с легкостью решать задачи, решение которых практически невозможно с помощью стандартных функций, либо для этого требуются формулы огромной длины. Примеры таких мегаформул можно посмотреть в решении задач:
Функции регулярных выражений в Excel
Для поддержки регулярных выражений при наличии подключенной надстройки !SEMTools в Excel будут работать три функции: REGEXMATCH, REGEXEXTRACT и REGEXREPLACE.
Их синтаксис и принцип работы аналогичны синтаксису Google Spreadsheets. Поэтому формулы, составленные в Excel, будут иметь практически полную совместимость с Google Spreadsheets. Отличия описаны ниже, в разделе про REGEXEXTRACT.
REGEXMATCH
REGEXMATCH возвращает ИСТИНА или ЛОЖЬ (TRUE или FALSE в английской версии Excel), в зависимости от того, соответствует текст паттерну или нет.
=REGEXMATCH("текст";"RegEx-паттерн для поиска") REGEXEXTRACT
REGEXEXTRACT извлекает первый попадающий под паттерн фрагмент текста. Небольшое отличие от Google Spreadsheets заключается в том, что, если в искомом тексте такого фрагмента нет, Spreadsheets отдают ошибку, а в надстройке отдается пустая строка. Второе отличие: если в шаблоне есть скобки, Google Таблицы возвращают содержимое скобок, а надстройка — совпадение целиком. Чтобы получить только группу, используйте REGEXREPLACE с $1, например =REGEXREPLACE(A2;".*цена: (\d+).*";"$1"). У функции надстройки есть и необязательные аргументы: третий — ИСТИНА, чтобы вернуть все совпадения, четвёртый — разделитель между ними: =REGEXEXTRACT(A2;"\d+";ИСТИНА;", ").
=REGEXEXTRACT("текст";"RegEx-паттерн для поиска") REGEXREPLACE
REGEXREPLACE заменяет все попадающие под паттерн фрагменты на указанное значение.
=REGEXREPLACE("текст";"RegEx-паттерн для поиска";"текст, которым заменяем найденное") | A | B | C | D | |
|---|---|---|---|---|
| 1 | Товар | REGEXEXTRACT | REGEXMATCH | REGEXREPLACE |
| 2 | Кабель USB-C 2м арт. 48213 | 48213=REGEXEXTRACT(A2;"\d{5}") | ИСТИНА=REGEXMATCH(A2;"арт\. \d{5}") | Кабель USB-C 2м=REGEXREPLACE(A2;" арт\. \d{5}";"") |
| 3 | Зарядка 65W арт. 10077 | 10077=REGEXEXTRACT(A3;"\d{5}") | ИСТИНА=REGEXMATCH(A3;"арт\. \d{5}") | Зарядка 65W=REGEXREPLACE(A3;" арт\. \d{5}";"") |
| 4 | Чехол без артикула | =REGEXEXTRACT(A4;"\d{5}") | ЛОЖЬ=REGEXMATCH(A4;"арт\. \d{5}") | Чехол без артикула=REGEXREPLACE(A4;" арт\. \d{5}";"") |
Шаблон \d{5} — ровно пять цифр подряд, поэтому «65» в «65W» не извлекается. Точка в «арт\.» экранирована: без обратного слеша она означала бы «любой символ». Если совпадения нет (A4), REGEXEXTRACT в !SEMTools возвращает пустую строку.
В английском Excel: =REGEXEXTRACT(A2,"\d{5}")
Регулярные выражения в Excel 365
В Excel 365 появились собственные функции регулярных выражений. Шаблоны из этой статьи работают и в них, но названия и синтаксис функций отличаются:
| Что делает | !SEMTools и Google Таблицы | Excel 365 |
|---|---|---|
| Проверяет соответствие шаблону | REGEXMATCH | РЕГТЕСТ (REGEXTEST) |
| Извлекает фрагмент | REGEXEXTRACT | РЕГИЗВЛЕЧЬ (REGEXEXTRACT) |
| Заменяет фрагменты | REGEXREPLACE | РЕГЗАМЕНИТЬ (REGEXREPLACE) |
Если у вас Excel 2010–2021 или вы делитесь файлами с коллегами, у которых нет Excel 365, функции !SEMTools остаются единственным способом пользоваться регулярками без VBA.
Шпаргалка по синтаксису регулярных выражений
Прежде чем перейти к примерам, соберу в одну таблицу символы, которые встретятся ниже. Запоминать сразу всё не нужно: возвращайтесь к таблице, когда будете составлять свой шаблон.
| Символ | Что означает | Пример |
|---|---|---|
| . | Любой символ | к.т — «кот», «кит», «к5т» |
| \d / \D | Цифра / любой символ, кроме цифры | \d\d — «24» |
| \w / \W | Латиница, цифра или подчёркивание / всё остальное | \w+ — «SKU_100» |
| \s / \S | Пробельный символ (пробел, табуляция, перенос строки) / любой другой | \s+ — несколько пробелов подряд |
| [абв] | Любой из перечисленных символов | [.,;] — точка, запятая или точка с запятой |
| [^абв] | Любой символ, кроме перечисленных | [^0-9] — всё, кроме цифр |
| [а-я] | Диапазон символов | [A-Za-z] — вся латиница |
| ^ / $ | Начало / конец строки (ячейки) | ^\d — ячейка начинается с цифры |
| \b | Граница слова | \b\d{4}\b — отдельно стоящие 4 цифры |
| * | Ноль или больше повторений | \d* — «», «7», «2024» |
| + | Одно или больше повторений | \d+ — «7», «2024» |
| ? | Ноль или одно повторение | руб\.? — «руб» и «руб.» |
| {n} / {n,} / {n,m} | Ровно n / n и больше / от n до m повторений | \d{4} — ровно 4 цифры |
| *? / +? | Ленивый квантификатор: как можно меньше символов | .*?\d — текст до первой цифры |
| | | ИЛИ | (com|ru) — «com» или «ru» |
| ( ) | Группа | (ab)+ — «ab», «abab» |
| \1 | Ссылка на первую группу: ровно то же, что в ней нашлось | (\d)\1 — «11», «77» |
| \ | Экранирование: спецсимвол становится обычным | \. — именно точка, а не любой символ |
Важный момент — \w не включает кириллицу. Если в шаблоне нужны русские буквы, указывайте их явно: [А-Яа-яЁё].
Примеры задач, решаемых с помощью регулярных выражений
Я не поскуплюсь на примеры, чтобы показать вам все возможности регулярных выражений, так как они действительно огромны. Надеюсь, эта статья послужит руководством и стимулом активнее пользоваться их мощью. От простого к сложному.
Чтобы дать обычным пользователям Excel возможность максимально широко использовать возможности регулярных выражений, в надстройку !SEMTools был добавлен ряд быстрых процедур. Все примеры ниже будут показаны с их использованием.
Извлечение данных из ячеек с помощью RegEx
Извлечь из ячейки содержимое до / после первой цифры включительно
.*?\d \d.* Такие простые два выражения. Точка обозначает любой символ, а «*» — квантификатор, повторение от нуля раз и больше. По умолчанию квантификаторы «жадные»: они захватывают как можно больше символов. Знак вопроса после «*» делает квантификатор «ленивым», и тогда выражение останавливается на первой же встреченной цифре.
Разница наглядна на строке «Артикул A-1024, партия 7 от 2023 года»:
- .*?\d вернёт «Артикул A-1» — текст до первой цифры;
- .*\d вернёт «Артикул A-1024, партия 7 от 2023» — текст до последней цифры;
- \d.* вернёт «1024, партия 7 от 2023 года» — всё, начиная с первой цифры.
«\d» обозначает «digits», иначе цифры. Поскольку квантификатора после «\d» в примерах выше нет, то одну цифру. Если потребуется исключить из результатов эту цифру, это можно сделать позднее. В !SEMTools есть простые способы удалить символы в начале или конце ячейки.
Цифры можно выразить и другим регулярным выражением:
[0-9] «Вытянуть» цифры из ячеек
Как извлечь из строки цифры? Регулярное выражение для такой операции будет безумно простым:
\d В зависимости от режима извлечения результатом будет либо первая, либо все цифры в ячейке.
Если их нужно вывести не сплошной последовательностью, а через разделитель, сохранив фрагменты, где цифры следуют друг за другом, выражение будет чуть иным, с квантификатором «+» (одно или больше повторений). А при извлечении нужно будет указать разделитель.
\d+ [0-9]+ Это справедливо и для любых других символов, пример с числами ниже:
Извлечь из ячейки числа из N цифр
Как видно в примере выше, помимо чисел, обозначающих годы, были извлечены и другие числа, например, «1». Чтобы извлечь исключительно последовательности из четырех цифр, потребуется видоизменить выражение. Есть несколько вариантов:
\d\d\d\d [0-9][0-9][0-9][0-9] \d{4} [0-9]{4} Последние два варианта включают квантификатор фигурные скобки. Он указывает точное количество повторений паттерна, стоящего непосредственно перед ним. В данном случае подряд должны идти ровно четыре цифры. У фигурных скобок есть и другие формы записи: {4,} — четыре и больше, {2,4} — от двух до четырёх.
Извлечь латиницу регулярным выражением
Выражение [a-zA-Z] обозначает все символы латиницы. Дефис и в этом, и в предыдущем случае обозначает, что берутся все символы между a и z и между A и Z в общей таблице символов Unicode. Квадратные скобки — синоним "ИЛИ". Рассматривается каждый из элементов или множеств внутри квадратных скобок, при этом выражение не находит ничего, только если сравниваемая строка не содержит ни одного элемента внутри квадратных скобок.
Аналогично для кириллицы используется [А-Яа-яЁё]. Букву «ё» приходится указывать отдельно: в таблице Unicode она стоит вне диапазона «А–я».
Извлечь символы в конце/начале строк по условию
Стандартные формулы ПРАВСИМВ и ЛЕВСИМВ позволяют извлечь из ячейки соответственно последние и первые N символов, но на этом их возможности заканчиваются.
С помощью же регулярных выражений можно извлечь:
- Последнее предложение ячейки, если оно восклицательное. Выражение: [А-ЯЁ][^.!?]*!$. Оно ищет заглавную букву, за которой идут любые символы, кроме знаков конца предложения, а в самом конце ячейки стоит «!». Из «Привет. Как дела!» извлечётся «Как дела!», а из «Мы в Москве!» — всё предложение целиком, несмотря на заглавную букву в середине.
- Первые символы из определенного множества, если ячейка с них начинается. Например, ^[A-Z]+ извлечёт латинский префикс артикула: из «SKU-100 чехол» получится «SKU». Если в начале ячейки латиницы нет, результат будет пустым.
- Аналогично: последние символы из множества, если ячейка на них заканчивается. Например, \d{1,3}$ извлечёт от одной до трёх цифр в конце ячейки: из «Чехол iPhone 15» получится «15».
Проверить ячейки на соответствие регулярному выражению
Если нет необходимости извлекать данные, а нужно лишь проверить, соответствуют ли они паттерну, чтобы потом отфильтровать их, удобнее использовать процедуру, эквивалентную формуле REGEXMATCH.
Найти в ячейке числа из N цифр
В зависимости от того, является N необходимым или достаточным условием, нужны разные регулярные выражения. Иными словами, считать ли последовательности из N+1, N+2 и т.д. цифр подходящими или нет. Если да, выражение будет таким же, как уже указывалось выше:
\d\d\d\d [0-9][0-9][0-9][0-9] \d{4} [0-9]{4} Если же нас интересуют строго последовательности из N цифр, проще всего воспользоваться границей слова \b:
\b\d{4}\b Такое выражение найдёт «2023» в строках «год 2023» и «2023-го», но не тронет «20231». Оговорюсь сразу: если цифры «прилеплены» к латинским буквам, как в «abc1234», граница слова не сработает. Для \b буквы и цифры — одинаковые «словесные» символы, и границы между ними нет.
Для таких случаев задачу придется решать в две итерации:
- В первую итерацию извлекать цифры вместе с границами строк или нецифровыми символами, идущими после/перед (это станет своеобразной проверкой отсутствия других цифр).
- И во вторую уже сами цифры.
Выражения для первой итерации будут, соответственно:
(^|\D)\d\d\d\d($|\D) (^|\D)[0-9][0-9][0-9][0-9]($|\D) (^|\D)\d{4}($|\D) (^|\D)[0-9]{4}($|\D) Для второй итерации из полученных фрагментов достаточно извлечь \d{4}.
Если внимательно посмотреть на отличие в синтаксисе, можно понять, что означают символы в нем:
- вертикальная черта "|" обозначает "ИЛИ",
- скобки "( )" нужны для перечисления внутри них аргументов и "отгораживания" их от остального выражения,
- каретка "^" обозначает начало строки,
- символ доллара "$" — конец строки,
- \D — нечисловые символы. Обратите внимание: верхний регистр меняет значение \d на противоположное. Это справедливо также для пар \w и \W (латиница, цифры и подчёркивание — и все остальные символы) и \s и \S (различные виды пробелов — и непробельные символы).
Найти ячейки, начинающиеся с цифр
Выражение для подобной проверки будет:
=REGEXMATCH(A1;"^\d.*") Либо можно воспользоваться процедурой проверки на копии исходного диапазона без необходимости вводить формулу. Смотрите примеры.
Найти повторы и зеркальные числа (обратные ссылки)
Этот раздел появился благодаря вопросу читателя: как найти в массиве чисел «зеркальные» номера вроде 4915491? Сначала одно уточнение. Число 4915491 на самом деле не зеркальное: справа налево оно читается как 1945194. В нём один и тот же блок «491» стоит по краям, а между ними одна цифра. Зеркальным (палиндромом) было бы 4915194. Шаблоны для этих двух случаев разные, поэтому разберу оба.
Оба решения строятся на обратных ссылках. Скобки не только группируют часть выражения, но и запоминают найденное, а \1, \2 и т.д. требуют, чтобы дальше в строке встретилось ровно то же самое.
Повтор блока по краям, как в 4915491. Для семизначных чисел вида «3 цифры + 1 + те же 3»:
=REGEXMATCH(A1;"^(\d{3})\d\1$") - ^ и $ — начало и конец ячейки;
- (\d{3}) — три цифры, запомненные в группу;
- \d — одна цифра посередине;
- \1 — ссылка на группу, то есть ровно те же три цифры ещё раз.
Настоящее зеркало (палиндром), как в 4915194. Для чисел заданной длины шаблон строится через обратный порядок групп. Например, для семизначных:
=REGEXMATCH(A1;"^(\d)(\d)(\d)\d\3\2\1$") Первая цифра должна совпасть с последней, вторая с предпоследней и так далее.
Замена подстрок по регулярному выражению
Наиболее частый кейс такой замены — замена на пустоту, когда наша задача попросту удалить из текста определенные символы. Наиболее популярны:
- удаление цифр из текста — шаблон \d,
- удаление пунктуации — шаблон [.,!?;:«»"()],
- всех символов, кроме букв и цифр — шаблон [^A-Za-zА-Яа-яЁё0-9 ].
Например, так выглядит формула, удаляющая все символы, кроме букв, цифр и пробелов:
=REGEXREPLACE(A1;"[^A-Za-zА-Яа-яЁё0-9 ]";"") Обратите внимание: короткий вариант [^\w ] здесь не подойдёт. \w не включает кириллицу, и формула удалит заодно все русские буквы.
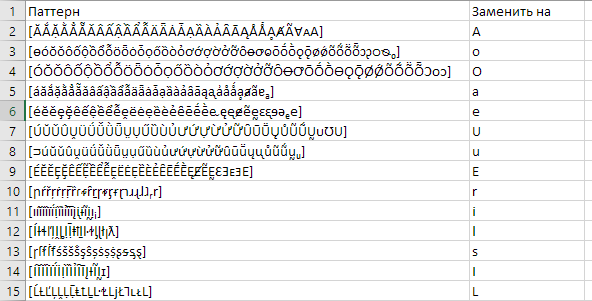
Но бывают случаи, когда необходима реальная замена, например, когда нужно заменить буквы с "хвостиками"/умляутами/ударениями и прочими символами из европейских алфавитов на их английские аналоги. Задача популярна среди SEO-специалистов, формирующих урлы сайтов этих стран на основе оригинальной семантики. Так выглядит начало таблицы паттернов для замены диакритических символов на латиницу с помощью RegEx при генерации URL:
Разбить ячейку по буквам
Чтобы разбить ячейку посимвольно, достаточно извлечь все символы через разделитель. Выражением для извлечения будет обычная точка — она как раз и обозначает любой символ.
Разбить буквы и цифры в ячейке
Если строго соблюдать постановку этой задачи, ее выполнить довольно сложно. Но зато с помощью регулярных выражений можно отделить цифровые последовательности символов от нецифровых. Так будет выглядеть выражение:
([^\d.]+|[\d.]+) Точка добавлена к цифрам намеренно, чтобы дробные числа вроде «2.5» не разрывались на части.
А так будет выглядеть процесс на практике:
Подробнее об этой задаче, в том числе о решении формулами без регулярок, смотрите в статье «Как разделить текст и цифры в Excel».
Вставить текст после первого слова
При замене по регулярному выражению в !SEMTools есть опция замены не всех, а только первого найденного фрагмента, удовлетворяющего паттерну. Это позволяет решить задачу вставки символов после первого слова. Просто заменим первый пробел на нужные нам символы с помощью соответствующей процедуры (эту задачу можно решить также с помощью функции ЗАМЕНИТЬ, но можно и воспользоваться функционалом замены по регулярному выражению). В отличие от штатной процедуры "Найти и заменить", здесь можно заменить только первое вхождение. В данном случае — первый пробел. Как видно, пробел ничем не отличается от обычного:
Вставить символ после каждого слова или перед ним
Надстройка решает эту задачу в два клика готовой процедурой в меню "Изменить слова", но можно воспользоваться и несложным выражением для замены:
($| ) (^| ) Выражения обозначают, что заменяются пробелы или конец строки в первом случае и пробелы или начало строк во втором. Вертикальная черта — то самое "ИЛИ".
А заменять будем, соответственно, на пробел с символом слева или справа. Процедура добавит лишний пробел перед ячейкой или после, поэтому от него желательно будет избавиться — удалить лишние пробелы или удалить символы в начале / конце ячейки.
Регулярные выражения для поиска конкретных слов в !SEMTools
Когда дело доходит до извлечения определенных слов, регулярные выражения становятся невероятно сложными. Поэтому надстройка !SEMTools упрощает задачу до применения паттернов RegEx на уровне слов как отдельных сущностей.
Найти слова по регулярному выражению
Процедура фактически разбивает ячейку на отдельные слова и проверяет каждое из них на соответствие вашему паттерну.
Какие это могут быть паттерны? Да самые разные: email-адреса, ИНН, даты. Можно искать профессиональную терминологию — медицинские термины на "-ит" (гастрит, бронхит), технические "ци(я|ю|и)" (оптимизация), должности (-ер, -ор, -ик).
Лингвистические паттерны позволяют находить слова на "-ние" (решение, внимание), прилагательные в превосходной степени (лучший, сильнейший), глаголы на "-овать" (использовать), слова с приставками (переделать, принести), аббревиатуры (ООО, IT, CRM) и специальные форматы типа №123/45 или N 67-89.
Несколько готовых шаблонов для таких задач:
| Что ищем | Шаблон | Найдёт |
|---|---|---|
| Слова на «-ит» | ит$ | гастрит, бронхит |
| Слова на «-ция», «-цию», «-ции» | ци(я|ю|и)$ | оптимизация, инструкцию |
| Глаголы на «-овать» | овать$ | использовать, рисовать |
| Аббревиатуры из 2–4 заглавных букв | ^[A-ZА-ЯЁ]{2,4}$ | ООО, IT, CRM |
| ИНН (10 или 12 цифр) | ^(\d{10}|\d{12})$ | 7707083893 |
| Даты вида ДД.ММ.ГГГГ | ^\d{2}\.\d{2}\.\d{4}$ | 18.10.2026 |
Извлечь слова по регулярному выражению
Вот так выглядит извлечение слов, содержащих латиницу и цифры, из массива слов, с помощью регулярного выражения:
([a-z]\d|\d[a-z]) Обратите внимание, что выражение означает, что цифра за буквой или буква за цифрой должны следовать непосредственно, без промежуточных символов между ними. Если нужно извлечь в том числе слова вида "asdf-13", "1234-d", понадобится обозначить возможность наличия символов между:
([a-z].*\d|\d.*[a-z]) Если в данных встречаются заглавные латинские буквы, замените [a-z] на [A-Za-z].
Удалить слова по регулярному выражению
Порой текст требует чистки от ненужных слов, и эти слова отличает соответствие определенному паттерну. Сформировав этот паттерн в виде регулярного выражения, можно легко удалить подобные слова из текста с помощью !SEMTools.
Как и при поиске, процедура проверяет на соответствие каждое слово отдельно, поэтому шаблоны получаются короткими:
- \d — удалит все слова, содержащие цифры: из «купить чехол iphone15 недорого 2024» останется «купить чехол недорого»;
- ^.{1,2}$ — удалит короткие слова из 1–2 символов, например предлоги и союзы «в», «и», «по»;
- [A-Za-z] — удалит слова с латиницей;
- ^[A-Za-z]+$ — удалит слова, состоящие только из латиницы, но оставит смешанные вроде «iPhone-чехол».
То же самое можно сделать и формулой, но шаблон придётся описывать для всей строки сразу. Например, удаление слов с цифрами:
=REGEXREPLACE(A1;"\S*\d\S*";"") \S* означает любые непробельные символы до и после цифры, то есть слово целиком. После такой замены в тексте останутся двойные пробелы, их потом нужно будет убрать.
Очистить ячейки, не соответствующие регулярному выражению
Когда в вашем распоряжении массив данных, где могут быть ошибки, с которыми разбираться некогда, и при этом нужно извлечь только стопроцентно подходящие данные, можно воспользоваться регулярными выражениями для очистки нерелевантных.
Примеры задач и шаблонов для них:
| Задача | Шаблон | Пройдёт проверку |
|---|---|---|
| Оставить ячейки ровно из 3 слов | ^\S+(\s\S+){2}$ | купить чехол iphone |
| Оставить ячейки ровно из 10 символов | ^.{10}$ | 9161234567 |
| Оставить ячейки, содержащие только цифры | ^\d+$ | 12345 |
| Оставить ячейки, содержащие только буквы | ^[A-Za-zА-Яа-яЁё]+$ | Москва |
| Оставить email-адреса в зонах .com и .ru | ^[\w.-]+@[\w.-]+\.(com|ru)$ | ivan.petrov@mail.ru |
Обратите внимание: во всех шаблонах есть ^ и $. Без них проверку пройдёт любая ячейка, где нужный фрагмент встречается хотя бы где-то. Например, шаблону \d+ соответствует и «12345», и «Артикул 7».
Так выглядит работа процедуры «Извлечь ячейки по регулярному выражению»:
Типичные ошибки в регулярных выражениях
Если шаблон находит не то или не находит ничего, в 99% случаев причина в одном из этих пунктов:
- Забыли про ^ и $. Шаблон \d{4} найдёт четыре цифры и в «12345», потому что ищет фрагмент, а не всю ячейку. Чтобы проверить ячейку целиком, используйте ^\d{4}$.
- Не экранировали спецсимвол. Точка, плюс, скобки, знак вопроса в регулярках — служебные символы. Чтобы искать именно точку в домене или плюс в номере телефона, ставьте перед ними обратный слеш: \., \+, \(.
- Потеряли букву «ё» или кириллицу целиком. Диапазон [А-я] не включает «Ё» и «ё», а \w не включает русские буквы вовсе. Надёжный вариант — [А-Яа-яЁё].
- Жадный квантификатор захватил лишнее. .* и .+ берут как можно больше символов. Если нужно остановиться на первом совпадении, добавьте «?»: .*?
- Формулы показывают ошибку #ИМЯ? у коллеги. Функции REGEXMATCH, REGEXEXTRACT и REGEXREPLACE работают там, где установлена !SEMTools. Перед отправкой файла замените формулы значениями.
Кстати, регулярные выражения работают не только с содержимым ячеек. С их помощью можно и парсить сайты в Excel: собирать цены, наличие, контакты и картинки товаров по списку адресов страниц.
Регулярные выражения в Excel — частые вопросы
Есть ли в Excel регулярные выражения?
В Excel для Microsoft 365 — да: функции РЕГТЕСТ (REGEXTEST), РЕГИЗВЛЕЧЬ (REGEXEXTRACT) и РЕГЗАМЕНИТЬ (REGEXREPLACE). В Excel 2010–2021 встроенных функций нет — их добавляет надстройка !SEMTools или макрос на VBA.
Как называется REGEXEXTRACT в русском Excel?
В русской версии Excel 365 — РЕГИЗВЛЕЧЬ. В !SEMTools функция называется REGEXEXTRACT в любой языковой версии Excel, как в Google Таблицах.
Как извлечь все числа из ячейки регулярным выражением?
Функция REGEXEXTRACT возвращает первое совпадение. Чтобы получить все числа, удалите всё, кроме цифр и пробелов: =REGEXREPLACE(A2;"[^\d ]";""), или используйте процедуру извлечения по регулярному выражению.
Как удалить слова по регулярному выражению?
Формулой REGEXREPLACE с пустой заменой, например =REGEXREPLACE(A2;"\S*\d\S*";"") удалит слова с цифрами, или процедурой удаления слов по паттерну в !SEMTools.
Раскройте возможности Excel на максимум!
Проверяйте, извлекайте и заменяйте данные по регулярным выражениям в любой версии Excel с !SEMTools — формулами или процедурами прямо в исходных ячейках. Функции регулярок доступны даже в бесплатной версии.
Итоги: с чего начать работу с регулярками
Надеюсь, на этой странице вы нашли то, что искали, и регулярки перестали казаться набором непонятных символов. Начните с простых шаблонов из шпаргалки: \d, [A-Za-z], ^ и $ решают большую часть повседневных задач. Сложные выражения постепенно сложатся из этих кирпичиков сами собой :)
Если задача типовая, её часто проще решить готовой процедурой без шаблонов: извлечь символы по типу или позиции, удалить слова по условию или найти ячейки по нескольким критериям.
Скажите пожалуйста, почему на regex101 эта регулярка работает (?<=\D[ ])(\d{0,3}[ ]?){0,3}\d+(,\d\d)
а у вас в надстройке выдает ошибку?
Не знаю, Антон, а в Google Spreadsheets работает?
А как с помощью регулярных выражений искать зеркальный номер? Например, 4915491 я хочу, чтобы находил из массива чисел?
Хороший вопрос, но есть уточнение.
Число 4915491 на самом деле не зеркальное: справа налево оно читается как 1945194.
В нём один и тот же блок «491» стоит по краям, а между ними одна цифра.
Зеркальным (палиндромом) было бы 4915194.
Шаблоны для этих двух случаев разные, поэтому разберу оба.
Повтор блока по краям, как в 4915491
Для семизначных чисел вида «3 цифры + 1 + те же 3»:
^(\d{3})\d\1$Формула в !SEMTools:
=regexmatch(A1;”^(\d{3})\d\1$”)Как устроен шаблон:
^ и $ — начало и конец ячейки;
(\d{3}) — три цифры, запомненные в группу;
\d — одна цифра посередине;
\1 — ссылка на группу, то есть ровно те же три цифры ещё раз.
Настоящее зеркало (палиндром), как в 4915194
Для чисел заданной длины шаблон строится через обратный порядок групп. Например, для семизначных:
=regexmatch(A1;”^(\d)(\d)(\d)\d\3\2\1$”)Первая цифра должна совпасть с последней, вторая с предпоследней и так далее.