Найти повторяющиеся значения в столбце Excel проще всего формулой =СЧЁТЕСЛИ($A$2:$A$100;A2)>1: она возвращает ИСТИНА напротив каждой ячейки, значение которой встречается в столбце больше одного раза, включая первое вхождение. Чтобы отметить только повторы, кроме первого, диапазон делают расширяющимся: =СЧЁТЕСЛИ($A$2:A2;A2)>1. Выделить дубли цветом без формул можно условным форматированием, а найти их в десятках тысяч строк за пару кликов — процедурами !SEMTools.
Перед поиском стоит ответить себе на несколько вопросов — от них зависит способ:
- Что именно повторяется: слова внутри ячеек, сами ячейки или целые строки?
- Считать ли дублем первое вхождение или только второе, третье и далее?
- Дубли ли «Москва» и «Москва » с лишним пробелом, «Москва» и «москва»? Если да, это неявные дубли.
- Где искать: внутри одного столбца или между двумя списками?
- Что делать с найденным: подсветить, посчитать число повторений или сразу удалить дубли?
Найти и выделить цветом дубликаты в Excel
Для выделения дубликатов ячеек подходит инструмент условное форматирование. В процедуре есть ряд готовых правил, в том числе и для повторяющихся значений.
Найти инструмент можно на вкладке программы "Главная":
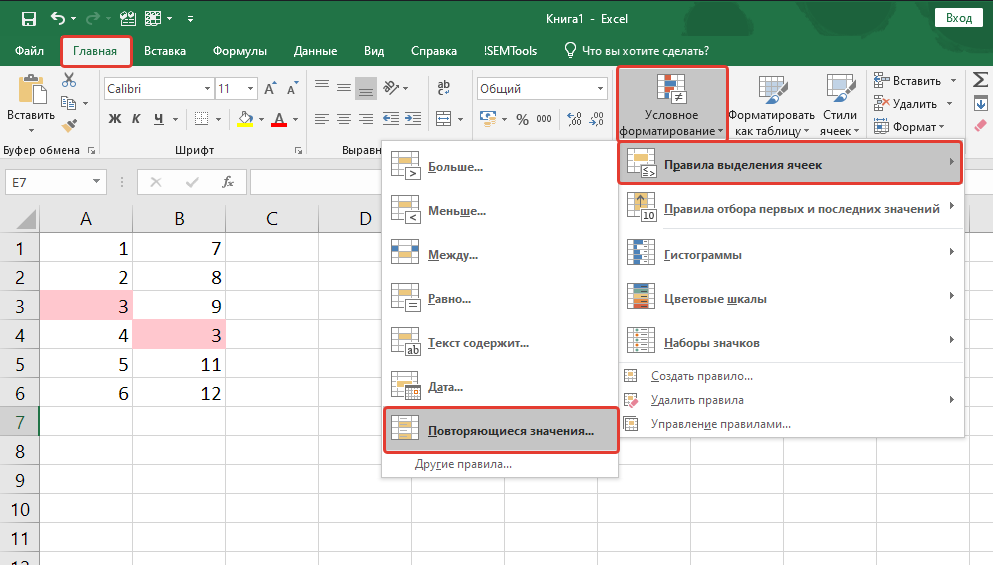
Процедура интуитивно понятна:
- Выделяем диапазон, в котором хотим найти дубликаты.
- Вызываем процедуру.
- Выбираем форматирование для отобранных ячеек (есть предустановленные форматы или же можно задать свой вариант).
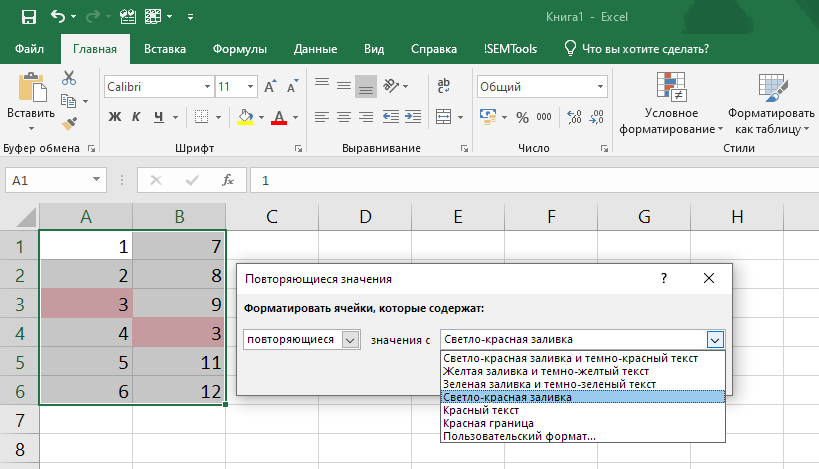
Важно понимать, что процедура находит дубликаты внутри всего диапазона и поэтому может не быть применима для сравнения двух столбцов. Достаточно иметь дубликаты внутри одного столбца — и процедура подсветит их оба, хотя во втором их не будет:
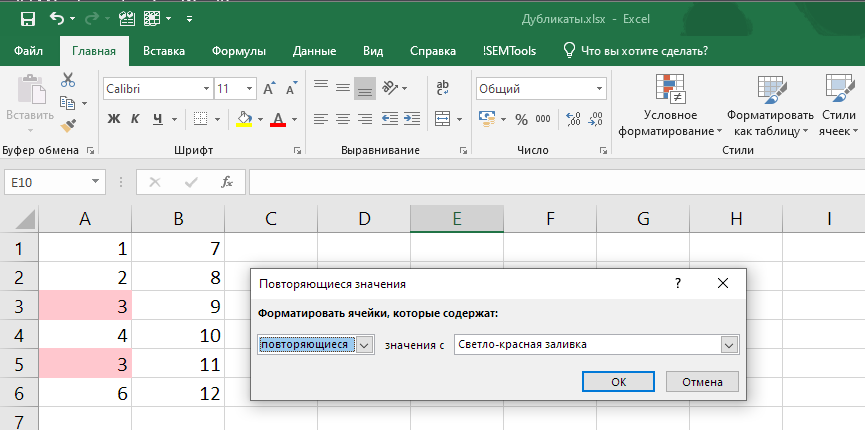
Данное поведение является неочевидным, и об этом факте часто забывают. Если дальше вы планируете удалять повторы, можете потерять оба варианта в одном столбце.
Как избежать подобной ситуации, если хочется найти именно дубли в другом столбце? Простейшее решение: удалить дубли внутри каждого столбца перед применением условного форматирования.
Но есть и другие решения. О них дальше.
Если нужно подсветить только те значения первого столбца, которые есть во втором, правило строят на формуле — как это сделать, показываю ниже, в разделе про два столбца.
Найти повторяющиеся значения формулой СЧЁТЕСЛИ
Формула удобнее условного форматирования тем, что её результат можно отфильтровать, посчитать и видоизменить под задачу. Основа почти всех формул поиска дублей — функция СЧЁТЕСЛИ: она считает, сколько раз значение ячейки встречается в диапазоне. Если больше одного раза — это дубль.
Отметить дубли в столбце, включая первый
Закрепляем диапазон знаками $, а проверяемую ячейку оставляем относительной — так формулу можно протянуть вниз:
| A | B | C | |
|---|---|---|---|
| 1 | Город | Дубль? | Сколько раз |
| 2 | Москва | ИСТИНА=СЧЁТЕСЛИ($A$2:$A$7;A2)>1 | 2=СЧЁТЕСЛИ($A$2:$A$7;A2) |
| 3 | Казань | ИСТИНА=СЧЁТЕСЛИ($A$2:$A$7;A3)>1 | 2=СЧЁТЕСЛИ($A$2:$A$7;A3) |
| 4 | Самара | ЛОЖЬ=СЧЁТЕСЛИ($A$2:$A$7;A4)>1 | 1=СЧЁТЕСЛИ($A$2:$A$7;A4) |
| 5 | Москва | ИСТИНА=СЧЁТЕСЛИ($A$2:$A$7;A5)>1 | 2=СЧЁТЕСЛИ($A$2:$A$7;A5) |
| 6 | Пермь | ЛОЖЬ=СЧЁТЕСЛИ($A$2:$A$7;A6)>1 | 1=СЧЁТЕСЛИ($A$2:$A$7;A6) |
| 7 | Казань | ИСТИНА=СЧЁТЕСЛИ($A$2:$A$7;A7)>1 | 2=СЧЁТЕСЛИ($A$2:$A$7;A7) |
Нажмите на ячейку, чтобы увидеть её формулу, или включите «Формулы». Москва и Казань встречаются дважды — ИСТИНА стоит у обоих вхождений. Столбец C показывает, сколько раз повторяется каждое значение.
В английском Excel: =COUNTIF($A$2:$A$7,A2)>1
Цветом в примере выделены ячейки, для которых формула вернула ИСТИНА. Дальше по столбцу B удобно включить фильтр и оставить только дубли.
Отметить повторы, кроме первого вхождения
Если первое вхождение нужно оставить, а пометить только второе, третье и далее, закрепляем лишь начало диапазона. Тогда при протягивании диапазон растёт: в строке 5 формула смотрит на A2:A5, в строке 7 — на A2:A7, и считает только то, что выше текущей ячейки.
| A | B | |
|---|---|---|
| 1 | Город | Повтор? |
| 2 | Москва | ЛОЖЬ=СЧЁТЕСЛИ($A$2:A2;A2)>1 |
| 3 | Казань | ЛОЖЬ=СЧЁТЕСЛИ($A$2:A3;A3)>1 |
| 4 | Самара | ЛОЖЬ=СЧЁТЕСЛИ($A$2:A4;A4)>1 |
| 5 | Москва | ИСТИНА=СЧЁТЕСЛИ($A$2:A5;A5)>1 |
| 6 | Пермь | ЛОЖЬ=СЧЁТЕСЛИ($A$2:A6;A6)>1 |
| 7 | Казань | ИСТИНА=СЧЁТЕСЛИ($A$2:A7;A7)>1 |
Москва в строке 2 и Казань в строке 3 — первые вхождения, они получают ЛОЖЬ. ИСТИНА только у повторов в строках 5 и 7. Отфильтруйте ИСТИНА — и получите строки, которые можно удалить без потери уникальных значений.
В английском Excel: =COUNTIF($A$2:A5,A5)>1
Проверить, есть ли в диапазоне дубли
Чтобы одной ячейкой ответить на вопрос «есть ли в диапазоне повторы вообще», подойдёт формула массива на основе СЧЁТЕСЛИ и СУММПРОИЗВ. СЧЁТЕСЛИ считает вхождения каждого значения, минус единица оставляет только лишние повторы, СУММПРОИЗВ их складывает:
| A | B | C | |
|---|---|---|---|
| 1 | Артикул | Проверка | |
| 2 | 1001 | Есть дубли? | ИСТИНА=СУММПРОИЗВ(СЧЁТЕСЛИ(A2:A6;A2:A6)-1)>0 |
| 3 | 1002 | Ячеек с дублями | 2=СУММПРОИЗВ(СЧЁТЕСЛИ(A2:A6;A2:A6)-1) |
| 4 | 1003 | ||
| 5 | 1002 | ||
| 6 | 1004 |
Артикул 1002 встречается дважды: для обеих его ячеек СЧЁТЕСЛИ возвращает 2, после вычитания единицы остаётся 1 + 1 = 2 (ячейка C3). Сумма больше нуля — значит, дубли в диапазоне есть (ячейка C2). У уникальных артикулов после вычитания получается 0, и в сумму они не попадают.
В английском Excel: =SUMPRODUCT(COUNTIF(A2:A6,A2:A6)-1)>0
Найти одинаковые значения в двух столбцах
Чтобы найти значения первого столбца, которые есть во втором, СЧЁТЕСЛИ ищет каждую ячейку столбца A во всём столбце B. Если результат больше нуля — значение встречается в обоих списках:
| A | B | C | |
|---|---|---|---|
| 1 | Список 1 | Список 2 | Есть в списке 2? |
| 2 | Москва | Казань | ИСТИНА=СЧЁТЕСЛИ($B$2:$B$7;A2)>0 |
| 3 | Казань | Омск | ИСТИНА=СЧЁТЕСЛИ($B$2:$B$7;A3)>0 |
| 4 | Самара | Уфа | ЛОЖЬ=СЧЁТЕСЛИ($B$2:$B$7;A4)>0 |
| 5 | Пермь | Москва | ЛОЖЬ=СЧЁТЕСЛИ($B$2:$B$7;A5)>0 |
| 6 | Уфа | Тула | ИСТИНА=СЧЁТЕСЛИ($B$2:$B$7;A6)>0 |
| 7 | Томск | Сочи | ЛОЖЬ=СЧЁТЕСЛИ($B$2:$B$7;A7)>0 |
Москва, Казань и Уфа есть в обоих списках. Порядок строк не важен: формула ищет значение по всему столбцу B. Чтобы найти, наоборот, чего нет во втором списке, замените >0 на =0.
В английском Excel: =COUNTIF($B$2:$B$7,A2)>0
Ту же формулу можно вставить в правило условного форматирования: выделите A2:A7, выберите «Условное форматирование → Создать правило → Использовать формулу» и введите =СЧЁТЕСЛИ($B$2:$B$7;A2)>0. В отличие от готового правила «Повторяющиеся значения», такое правило не реагирует на дубли внутри одного столбца — подсвечивается только то, что есть в другом списке.
Найти дубли в столбце за пару кликов с !SEMTools
Когда-то я потратил немало времени, пользуясь перечисленными выше методами поиска повторяющихся значений. Все они мне не нравились. Причина была одна: это попросту медленно. Поэтому я решил сделать отдельные процедуры для поиска и удаления дубликатов в Excel в моей надстройке !SEMTools для Excel.
Давайте покажу, как они работают.
Найти дубли ячеек в столбце, кроме первого
Процедура позволяет выделить все вторые, третьи и т.д. повторяющиеся значения в столбце.
Найти в столбце дубли ячеек, включая первый
Зачастую нужно найти в столбце все повторяющиеся ячейки, включая первую, для того, чтобы далее отфильтровать их все.
Найти дубли в столбце без учета лишних пробелов
Если мы считаем дубликатами фразы, отличающиеся количеством пробелов между словами или после, наша задача — сначала избавиться от лишних пробелов, и далее произвести тот же поиск дубликатов.
Для первой операции в !SEMTools есть отдельный инструмент «Удалить лишние пробелы»:
Процедуры работают прямо на выделенном диапазоне: не нужны вспомогательные столбцы, протягивание и закрепление ссылок, а на десятках тысяч строк они не тормозят книгу, как сотни тысяч вычислений СЧЁТЕСЛИ.
Почему СЧЁТЕСЛИ не находит дубли — частые ошибки
Формула «не видит» дубли или, наоборот, находит лишние в нескольких типичных ситуациях. Разберём каждую.
Дубли отличаются лишними пробелами
Для СЧЁТЕСЛИ «Москва» и «Москва » с пробелом в конце — разные значения. Чтобы сравнивать текст без лишних пробелов, оборачиваем обе стороны в СЖПРОБЕЛЫ и считаем совпадения через СУММПРОИЗВ:
| A | B | C | |
|---|---|---|---|
| 1 | Город | СЧЁТЕСЛИ | Без пробелов |
| 2 | Москва | ЛОЖЬ=СЧЁТЕСЛИ($A$2:$A$6;A2)>1 | ИСТИНА=СУММПРОИЗВ(--(СЖПРОБЕЛЫ(A2)=СЖПРОБЕЛЫ($A$2:$A$6)))>1 |
| 3 | Москва | ЛОЖЬ=СЧЁТЕСЛИ($A$2:$A$6;A3)>1 | ИСТИНА=СУММПРОИЗВ(--(СЖПРОБЕЛЫ(A3)=СЖПРОБЕЛЫ($A$2:$A$6)))>1 |
| 4 | Санкт Петербург | ЛОЖЬ=СЧЁТЕСЛИ($A$2:$A$6;A4)>1 | ИСТИНА=СУММПРОИЗВ(--(СЖПРОБЕЛЫ(A4)=СЖПРОБЕЛЫ($A$2:$A$6)))>1 |
| 5 | Санкт Петербург | ЛОЖЬ=СЧЁТЕСЛИ($A$2:$A$6;A5)>1 | ИСТИНА=СУММПРОИЗВ(--(СЖПРОБЕЛЫ(A5)=СЖПРОБЕЛЫ($A$2:$A$6)))>1 |
| 6 | Казань | ЛОЖЬ=СЧЁТЕСЛИ($A$2:$A$6;A6)>1 | ЛОЖЬ=СУММПРОИЗВ(--(СЖПРОБЕЛЫ(A6)=СЖПРОБЕЛЫ($A$2:$A$6)))>1 |
В A3 после «Москва» стоит пробел, в A4 между словами два пробела. Обычная СЧЁТЕСЛИ (столбец B) не находит ни одного дубля, формула со СЖПРОБЕЛЫ (столбец C) находит обе пары.
В английском Excel: =SUMPRODUCT(--(TRIM(A3)=TRIM($A$2:$A$6)))>1
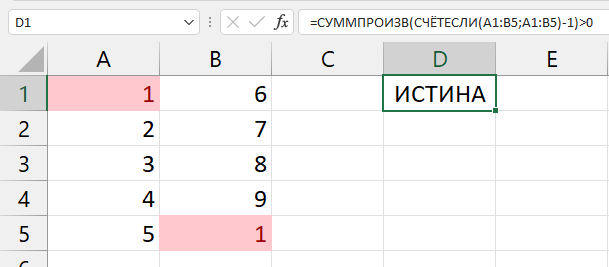
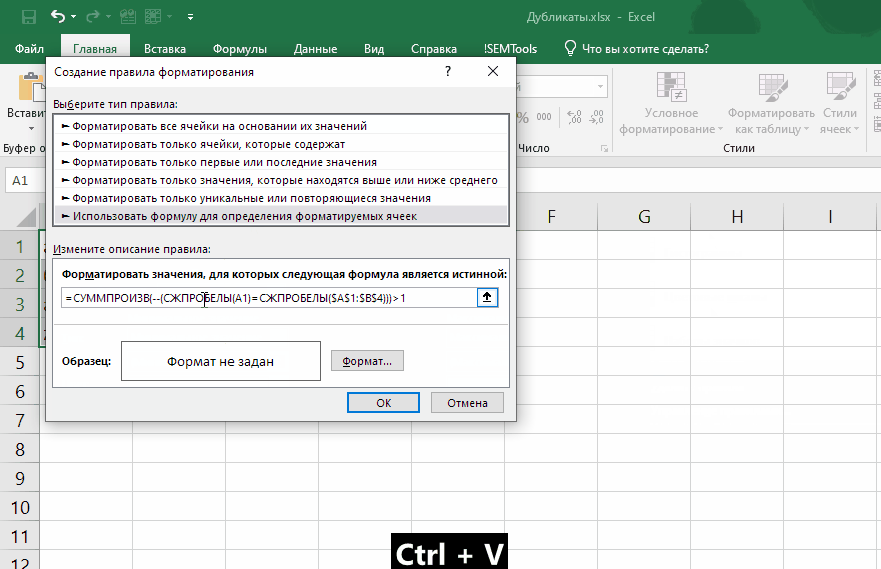
Эту же формулу можно задать правилом условного форматирования — тогда неявные дубли подсветятся прямо в диапазоне. Обратите внимание: диапазон закреплён ($A$1:$B$4), а проверяемая ячейка (A1) — нет. Именно это позволяет правилу проверять каждую ячейку диапазона.
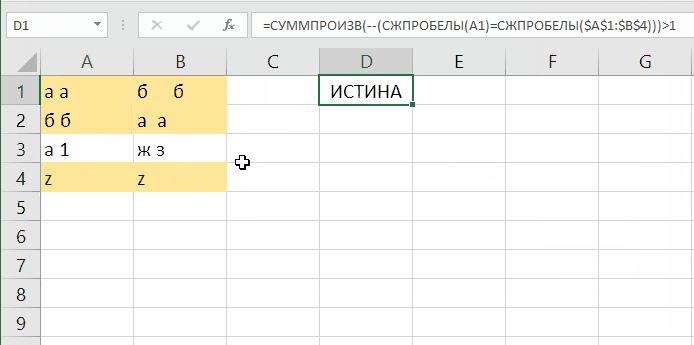
Учтите: СЖПРОБЕЛЫ не удаляет неразрывные пробелы (символ 160), которые часто приходят из выгрузок с сайтов. Их сначала заменяют обычными: =ПОДСТАВИТЬ(A2;СИМВОЛ(160);" "), или разом чистят процедурой удаления лишних пробелов.
Регистр букв не учитывается
СЧЁТЕСЛИ не различает регистр: «Москва», «москва» и «МОСКВА» для неё одно и то же. Если регистр важен (коды, артикулы, логины), считаем точные совпадения функцией СОВПАД:
| A | B | C | |
|---|---|---|---|
| 1 | Значение | СЧЁТЕСЛИ | С учётом регистра |
| 2 | Москва | ИСТИНА=СЧЁТЕСЛИ($A$2:$A$6;A2)>1 | ЛОЖЬ=СУММПРОИЗВ(--СОВПАД($A$2:$A$6;A2))>1 |
| 3 | москва | ИСТИНА=СЧЁТЕСЛИ($A$2:$A$6;A3)>1 | ЛОЖЬ=СУММПРОИЗВ(--СОВПАД($A$2:$A$6;A3))>1 |
| 4 | МОСКВА | ИСТИНА=СЧЁТЕСЛИ($A$2:$A$6;A4)>1 | ЛОЖЬ=СУММПРОИЗВ(--СОВПАД($A$2:$A$6;A4))>1 |
| 5 | Казань | ИСТИНА=СЧЁТЕСЛИ($A$2:$A$6;A5)>1 | ИСТИНА=СУММПРОИЗВ(--СОВПАД($A$2:$A$6;A5))>1 |
| 6 | Казань | ИСТИНА=СЧЁТЕСЛИ($A$2:$A$6;A6)>1 | ИСТИНА=СУММПРОИЗВ(--СОВПАД($A$2:$A$6;A6))>1 |
СЧЁТЕСЛИ считает дублями все три «Москвы». СОВПАД сравнивает посимвольно, поэтому дублем остаётся только «Казань», записанная одинаково.
В английском Excel: =SUMPRODUCT(--EXACT($A$2:$A$6,A2))>1
Звёздочки, вопросительные знаки и длинный текст
- Символы * и ? в значении СЧЁТЕСЛИ понимает как подстановочные: ячейка «ООО*» совпадёт с любым текстом, начинающимся на «ООО». Для таких данных используйте вариант с СОВПАД из предыдущего примера или уберите звёздочки заранее.
- Если в ячейке больше 255 символов, СЧЁТЕСЛИ возвращает ошибку #ЗНАЧ!. Длинные тексты сравнивайте через СУММПРОИЗВ(--(A2=$A$2:$A$100)).
- Без знаков $ диапазон «съезжает» при протягивании формулы вниз: в нижних строках СЧЁТЕСЛИ проверяет уже не весь столбец, и часть дублей теряется. Закрепляйте диапазон клавишей F4.
Повторяющиеся значения в Excel — частые вопросы
Как найти повторяющиеся значения в столбце Excel?
Быстрее всего — «Главная → Условное форматирование → Правила выделения ячеек → Повторяющиеся значения». Если нужен результат в ячейках, используйте формулу =СЧЁТЕСЛИ($A$2:$A$100;A2)>1 и протяните её вниз: ИСТИНА — дубль.
Как найти одинаковые значения в двух столбцах?
Формула =СЧЁТЕСЛИ($B$2:$B$100;A2)>0 возвращает ИСТИНА, если значение из столбца A есть в столбце B. Чтобы найти отсутствующие значения, замените >0 на =0.
Как выделить повторы, кроме первого вхождения?
Используйте расширяющийся диапазон: =СЧЁТЕСЛИ($A$2:A2;A2)>1. Первое вхождение получит ЛОЖЬ, все следующие — ИСТИНА. Формулу можно вставить и в правило условного форматирования.
Почему условное форматирование выделяет дубли не там, где ожидалось?
Правило «Повторяющиеся значения» ищет повторы во всём выделенном диапазоне. Если выделить два столбца, подсветятся и дубли внутри каждого из них. Для сравнения двух списков используйте правило с формулой =СЧЁТЕСЛИ($B$2:$B$100;A2)>0.
Найти дубли в столбце — включая первое вхождение или кроме него, без учёта лишних пробелов — в Excel можно быстрее с !SEMTools: прямо в исходных ячейках, без формул и вспомогательных столбцов.
!SEMTools решает эту и сотни других задач в пару кликов!
Итоги: каким способом искать дубли в Excel
Надеюсь, на этой странице вы нашли то, что искали, и смогли найти повторяющиеся значения в своей таблице. Коротко о том, что выбрать:
| Задача | Условное форматирование | Формула СЧЁТЕСЛИ | !SEMTools |
|---|---|---|---|
| Подсветить дубли в одном столбце | Да, готовое правило | Да, в правиле | Да |
| Дубли, кроме первого вхождения | Только правилом с формулой | Да, расширяющийся диапазон | Да, отдельная процедура |
| Совпадения в двух столбцах | Только правилом с формулой | Да | — |
| Без учёта лишних пробелов | Только правилом с формулой | Да, со СЖПРОБЕЛЫ | Да, в связке с удалением пробелов |
| Десятки тысяч строк | Медленно | Медленно, тяжёлая книга | Быстро, без формул |
Для разовой проверки хватит условного форматирования, для сравнения списков — формулы. Если же дубли приходится искать регулярно, проще делать это процедурой на месте, без формул и протягивания. Вас наверняка заинтересуют и похожие операции: удалить дубли без смещения строк, удалить повторяющиеся слова внутри ячеек и посчитать количество повторяющихся значений.
=IF(COUNTIFS($D$2:D2;D2)=COUNTIFS(D:D:D2;D2);1;0)